
Управление проблемами в ИТ: как сократить повторные сбои
Практическое руководство по работе с причинами сбоев: от регистрации проблемы до ее закрытия

Когда сервис перестает работать, команда старается как можно быстрее вернуть пользователям доступ. После восстановления начинается разбор причин, но довести его до конца бывает сложно: у поддержки появляются новые обращения, а специалисты нужны на других задачах. Расследование откладывают до следующего сбоя, хотя у десятка похожих обращений может быть одна общая причина.
Чтобы ее найти и устранить, нужен отдельный процесс — управление проблемами. В статье расскажем, что это такое и как выстроить работу с причинами сбоев на примере Kaiten.
Что такое управление проблемами в ITIL
Управление проблемами (Problem Management) — практика, которая помогает находить причины уже случившихся и возможных инцидентов, устранять их или снижать их влияние на бизнес. Это одно из понятий ITIL — набора рекомендаций по управлению ИТ-услугами.
Проблема может существовать, даже когда сервис работает. Например, команда знает об ошибке в настройках, из-за которой система может отказать при высокой нагрузке. Сбоя еще не было, но его причина уже есть — и с ней тоже можно работать.
Проблем-менеджмент тесно связан с другими практиками:
- Incident Management — восстановление работы сервиса после сбоя и сокращение последствий для пользователей. Об управлении инцидентами мы подробно рассказывали в отдельной статье.
- Monitoring and Event Management — наблюдение за состоянием сервисов и получение данных об отклонениях, которые могут указывать на существующие или потенциальные проблемы.
- Change Enablement — оценка рисков необходимых изменений и организация их согласования.
- Knowledge Management — сохранение результатов расследований, инструкций и решений, которыми смогут пользоваться другие специалисты.
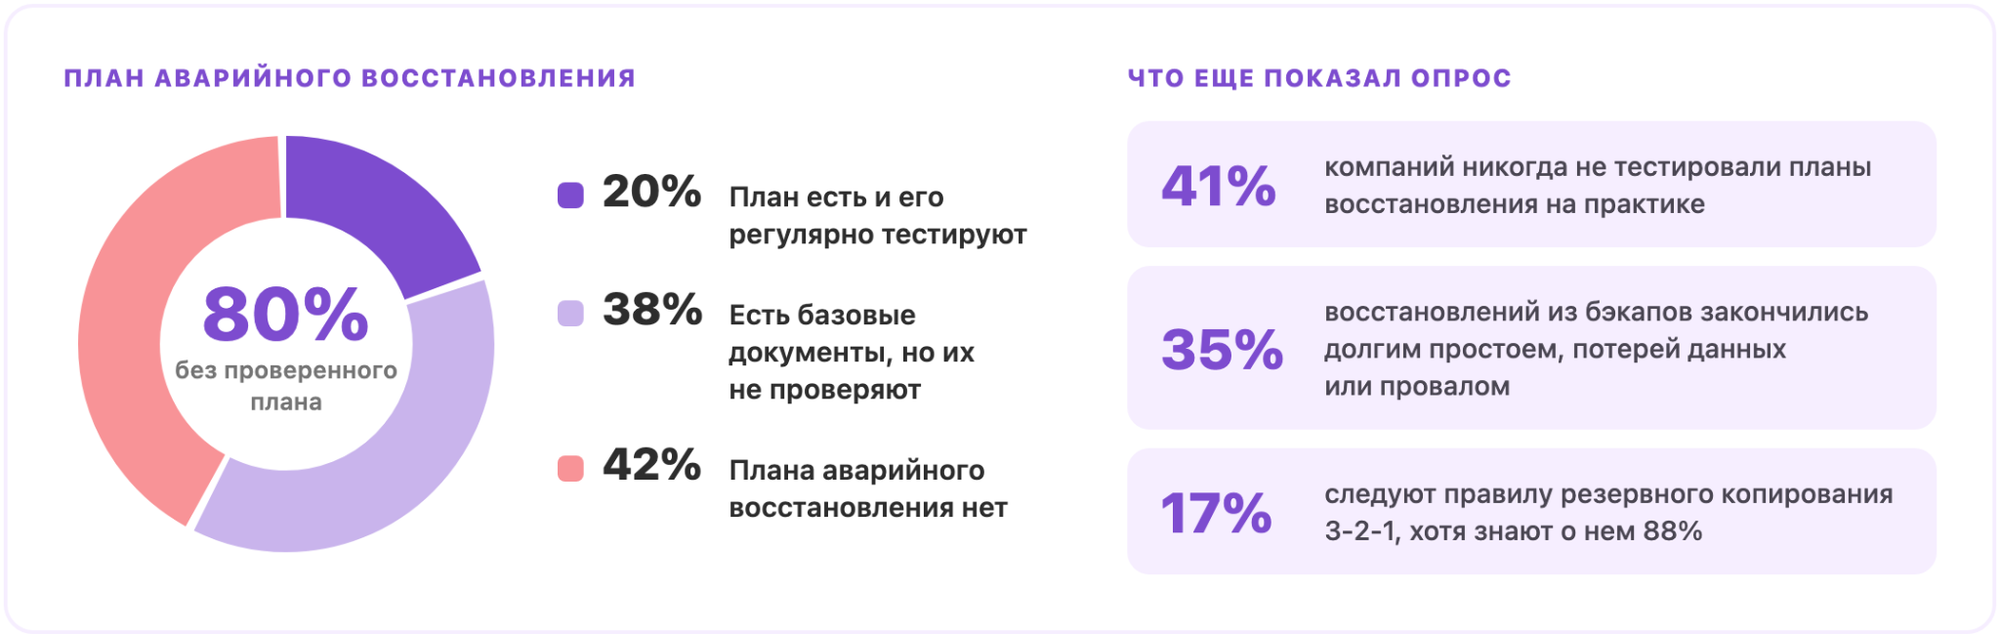
Сами риски при этом не всегда заметны в повседневной работе сервисов. По данным исследования Linx Cloud и Global CIO от мая 2026 года, в котором участвовали 100+ ИТ-руководителей из России и стран СНГ, только 20% опрошенных компаний имеют план аварийного восстановления и регулярно тестируют его — как правило, один-два раза в год. Еще у 38% есть базовые документы, которые не проверяют на практике, а у 42% плана нет вообще. Если такая площадка выйдет из строя, под угрозой может оказаться само существование компании.
Рассмотрим условный пример: сотрудники периодически не могут зайти в CRM — на сервере заканчивается место. Поддержка удаляет накопившиеся временные файлы, и система снова работает. Через неделю место заканчивается опять. После анализа инцидента становится понятно: автоматическая очистка файлов перестала работать после обновления. Команда исправляет проблему и проверяет, что файлы удаляются по расписанию.
В этой ситуации важно различать три понятия:
| Понятие | Что означает | Пример |
|---|---|---|
| Инцидент | Незапланированный перерыв в работе сервиса или ухудшение его качества | Сотрудники не могут зайти в CRM |
| Проблема | Причина или потенциальная причина одного или нескольких инцидентов | Временные файлы накапливаются и заполняют диск, потому что автоматическая очистка не работает |
| Известная ошибка | Проанализированная проблема, которую пока не устранили | Команда выяснила, что автоматическая очистка хранилища перестала работать после обновления, и готовит исправление |
Главное, чем отличается проблема от инцидента: инцидент — это сам сбой, а проблема — его причина. Поэтому одна проблема может вызывать множество инцидентов. Верно и обратное: у одного сбоя бывает несколько причин. Например, хранилище переполнено, потому что файлы стали занимать больше места, автоматическая очистка отключилась, а предупреждение о заполнении диска не настроили.
В рамках управления проблемами существует еще одно важное понятие — обходное решение, или workaround. Иными словами, это временный способ уменьшить последствия проблемы, если причина еще не устранена. Например, пока ИТ-специалисты готовят исправление, удалять ненужные временные файлы из хранилища можно вручную.
Реактивное и проактивное управление проблемами
Расследование проблемы может начаться после сбоя или до него. В зависимости от этого различают 2 подхода:
- Реактивное управление начинается после серии похожих инцидентов или одного серьезного отказа.
- Проактивное управление начинается еще до того, как инцидент наступил впервые. Основанием могут стать данные мониторинга, результаты тестов, сообщения разработчиков и поставщиков, история изменений и обращений.
На практике команды используют оба подхода. Реактивный помогает устранить причины сбоев, которые уже мешают пользователям, а проактивный — предотвратить сбои, которых еще не было. Этапы работы при этом одинаковые. Далее разберем их подробнее.
Этапы процесса управления проблемами
Инцидент считается закрытым, когда сервис снова работает. Проблема — когда команда знает причину сбоя и устранила ее. Ниже 5 этапов, которые помогают пройти этот путь. Их можно взять за основу и адаптировать под размер и процессы команды.
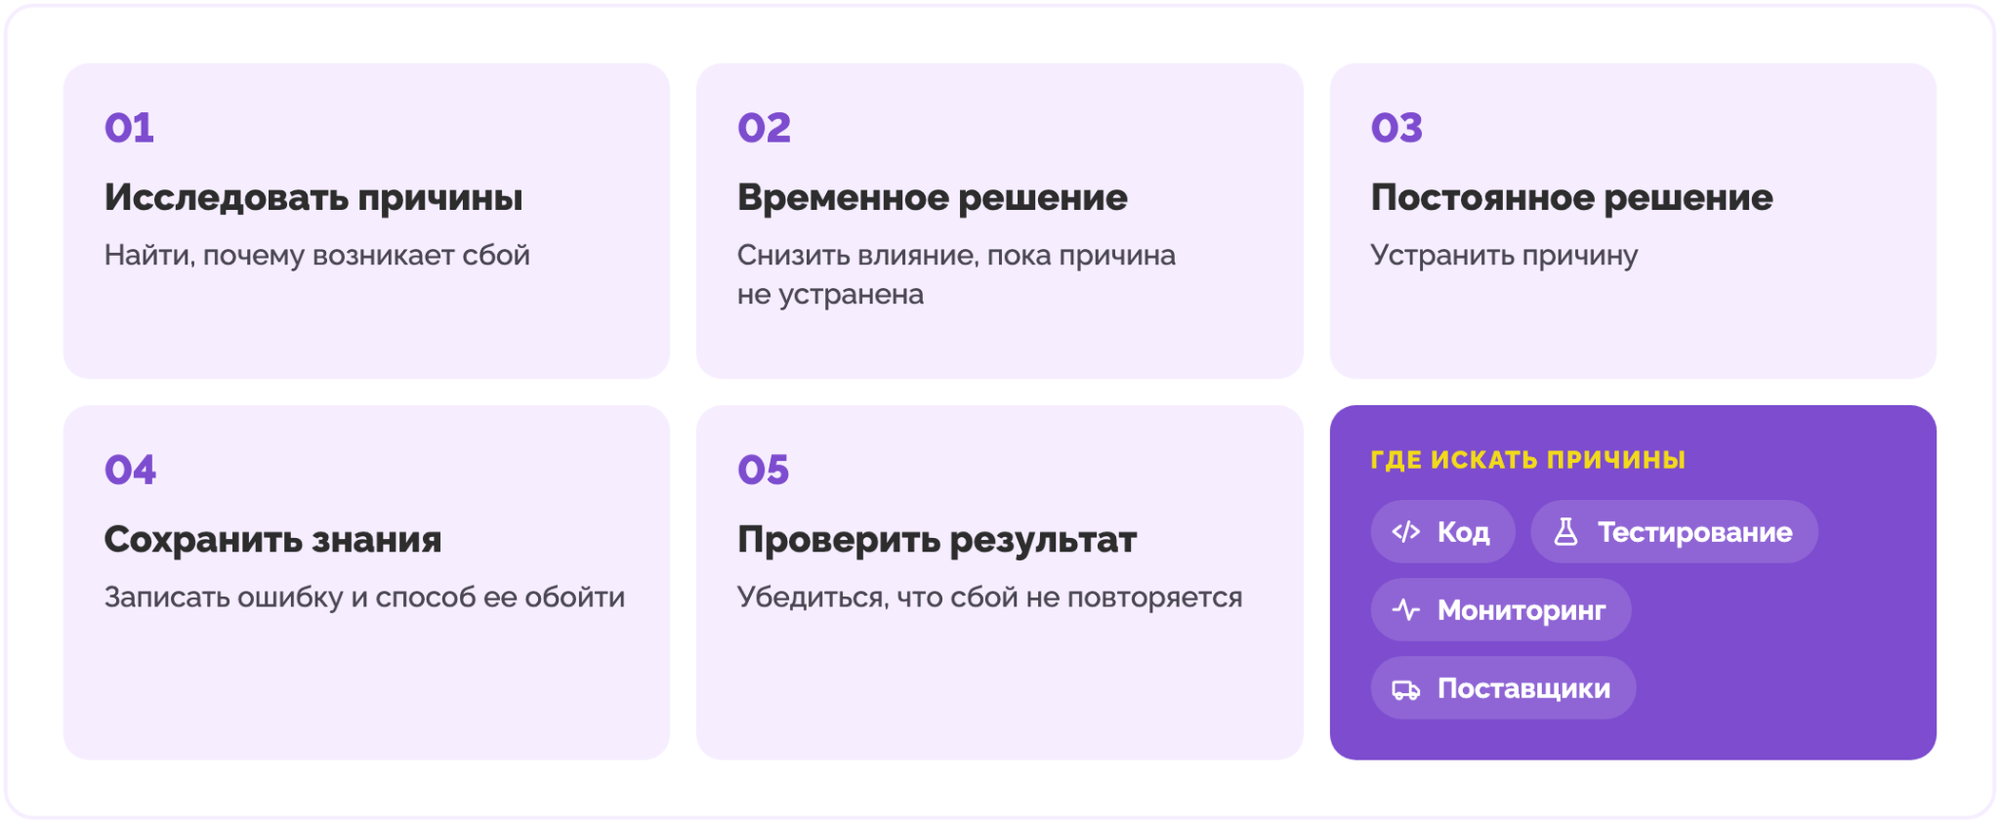
1. Исследовать причины
Заведите для проблемы отдельную карточку и свяжите с ней все инциденты, которые к ней относятся. Например, в Kaiten для каждой проблемы можно создать отдельную карточку и связать с обращениями о сбоях. Так видно, сколько раз сбой повторялся и каких пользователей затронул.
Для анализа первопричин (Root Cause Analysis, RCA) используют несколько методов:
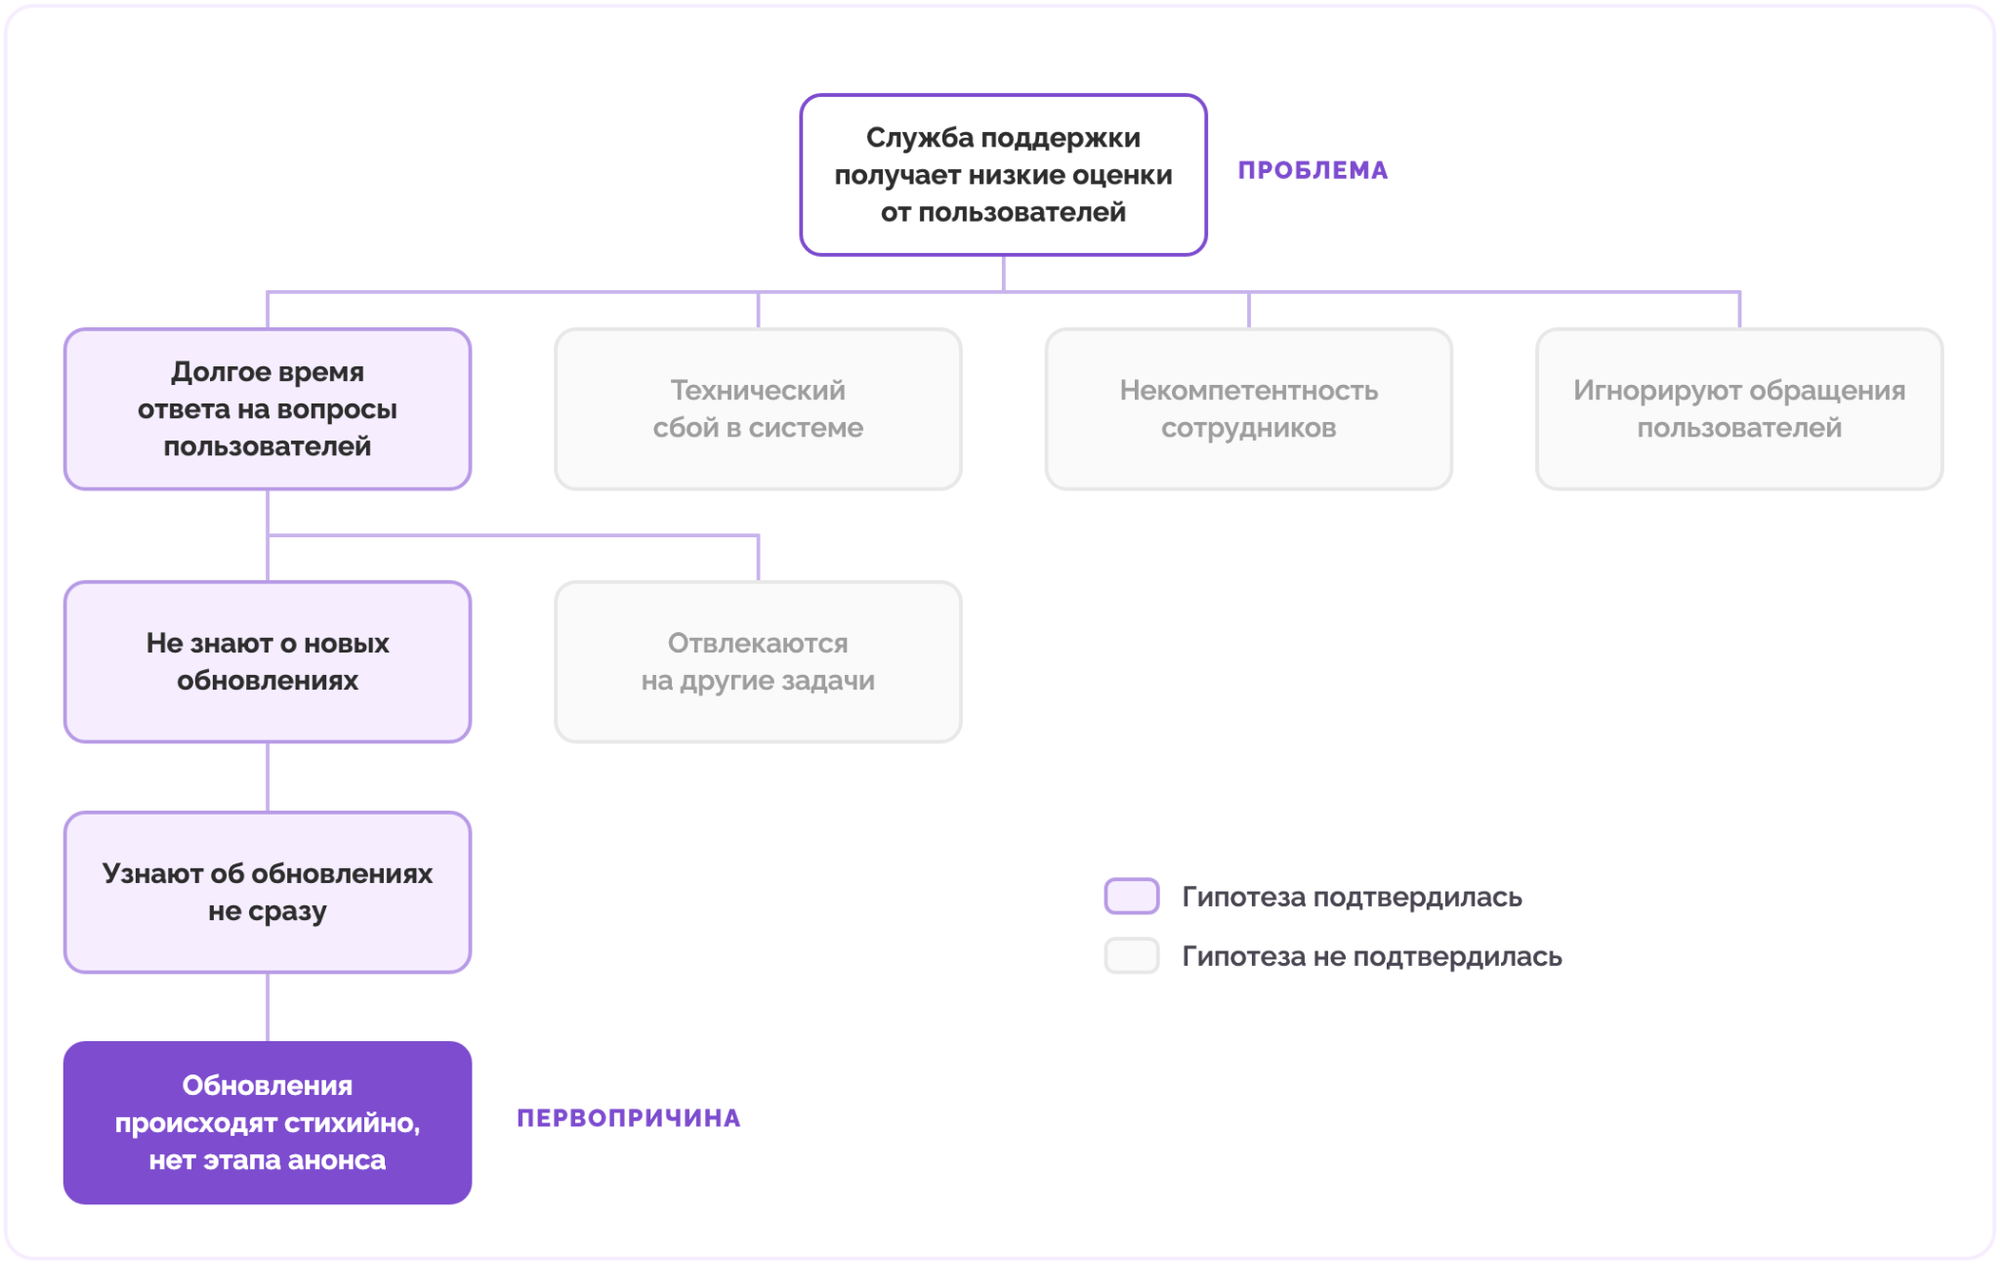
«Пять почему». Это метод из бережливого производства — он помогает перейти от симптома к причине через цепочку уточняющих вопросов. Каждый ответ подтверждайте данными.
Анализ временной линии. Соберите события по порядку: когда обновили систему, когда перестала запускаться очистка, когда появились первые ошибки.
Анализ журналов, мониторинга и зависимостей. Проверьте технические данные: какие ошибки записала система, как менялась нагрузка, какие компоненты работали со сбоями. По возможности воспроизведите ситуацию на тестовом стенде.
Диаграмма Исикавы. Если гипотез о причине сбоя много, распределите их по группам: код, настройки, оборудование, рабочие процессы, внешние сервисы или другие. Так будет проще увидеть, что уже проверили, а что могли упустить.
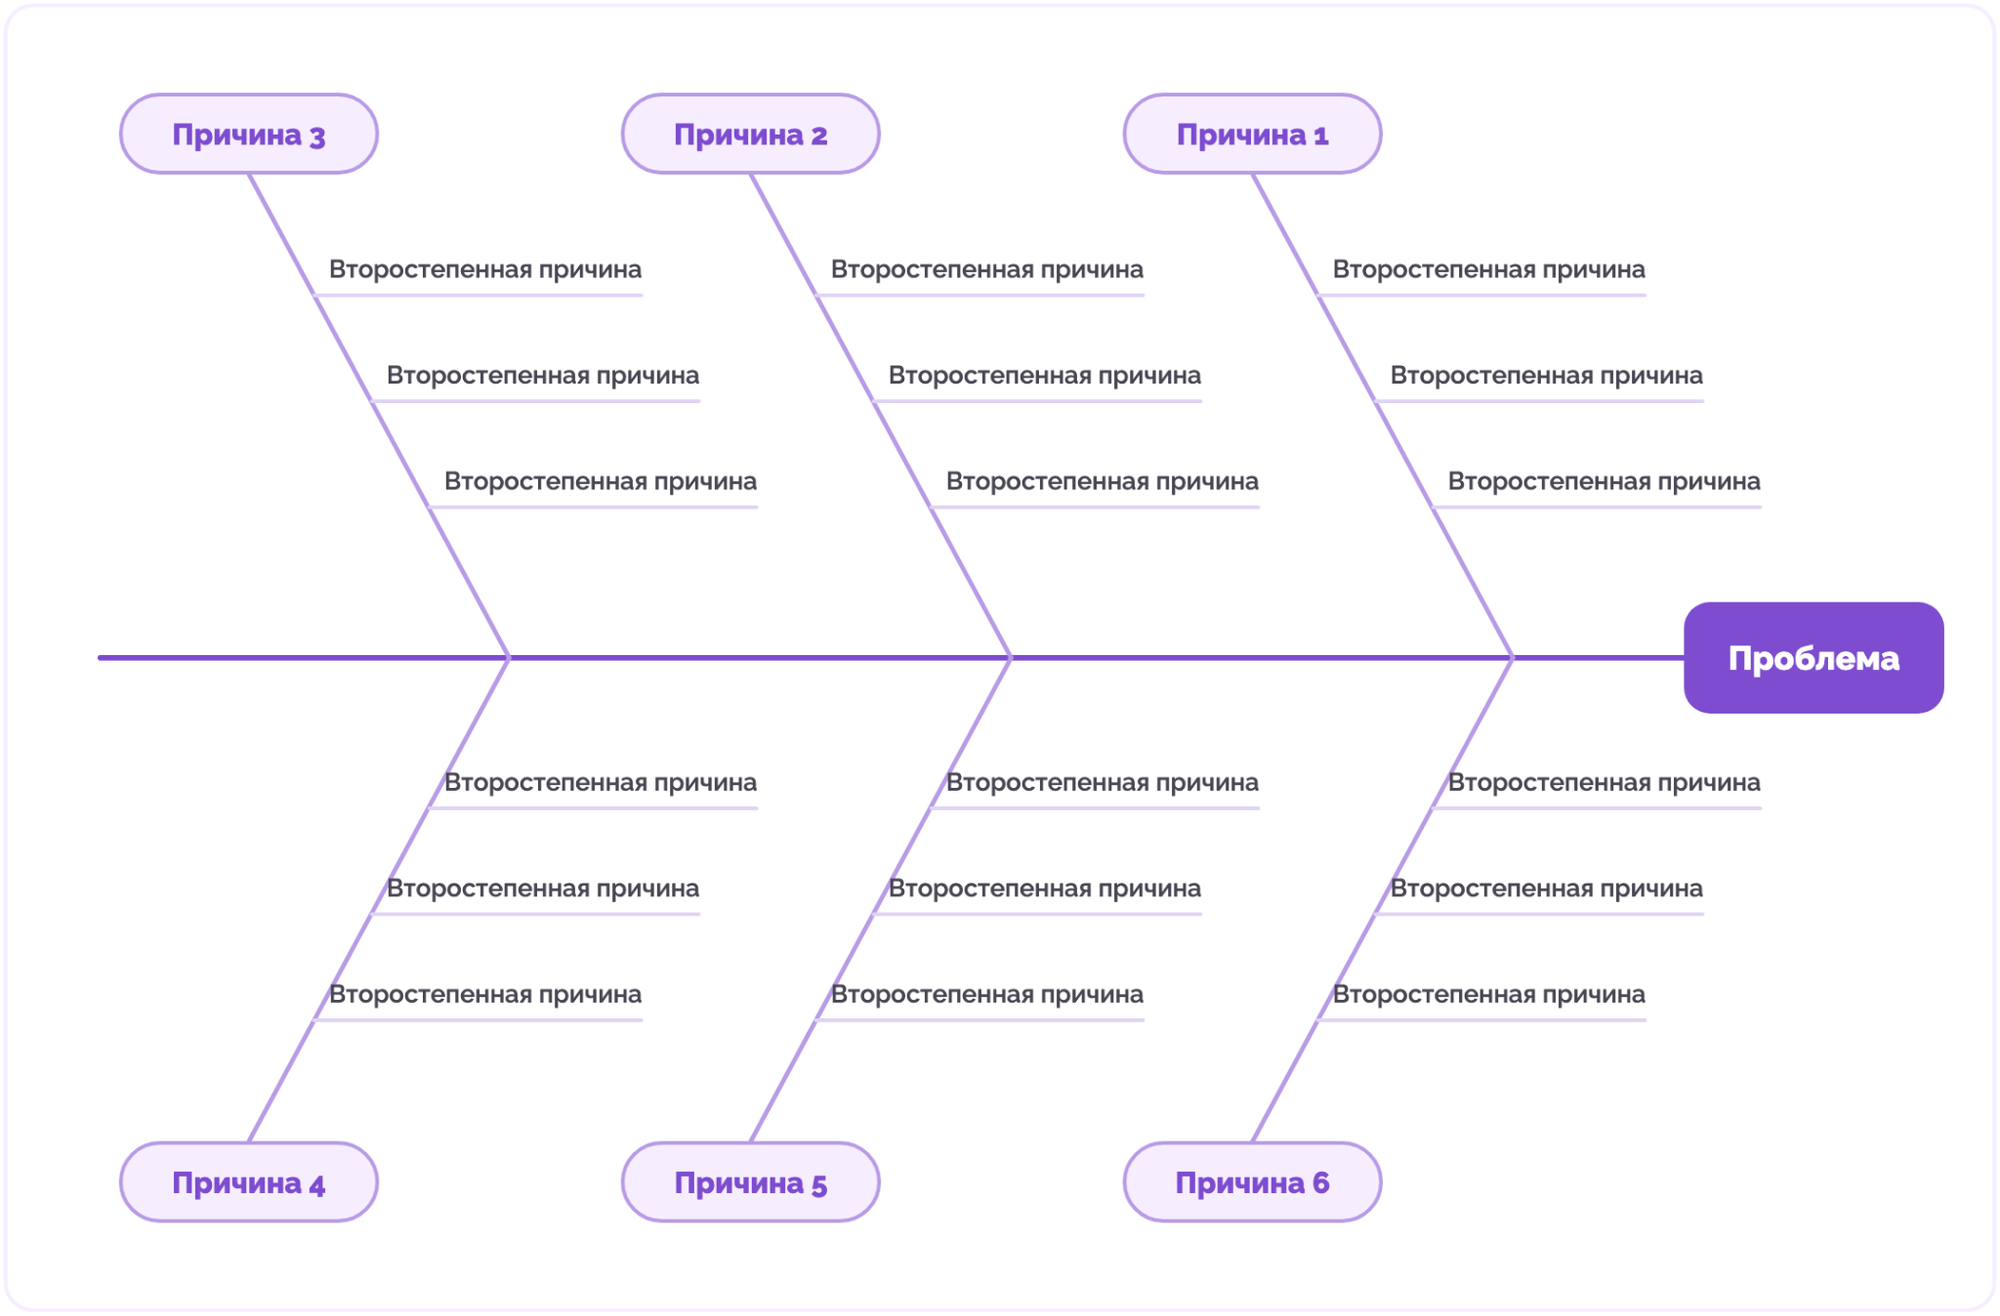
Все гипотезы фиксируйте в карточке чек-листом и отмечайте, какие подтвердились данными.
2. Подготовить временное решение
Восстановите доступ к сервису, даже если причина сбоя еще не найдена. Например, после обновления мобильное приложение не пускает пользователей в аккаунт, а веб-версия работает без ошибок. Предложите временно заходить в сервис через браузер, пока разработчики исправляют приложение.
3. Внедрить постоянное решение
Иногда достаточно поправить настройку, в других случаях потребуется доработка кода или замена оборудования. Перед значимыми изменениями оцените риски, проведите тесты и при необходимости подготовьте план отката.
4. Сохранить знания
Внесите ошибку, ее причину и обходной путь в базу известных ошибок — Known Error Database, или KEDB. Отдельная система для нее не нужна, подойдет база знаний с поиском. Например, в Документах Кайтена можно описать ошибку и вставить в тот же документ карточки задач на исправление — таблицей с фильтрами и нужными полями. Так рядом с описанием всегда виден актуальный статус работы.
5. Проверить результат
После внедрения исправления проблему не закрывают сразу. Сначала убедитесь, что связанные инциденты не повторяются при прежней нагрузке и не появилось новых ошибок. Срок наблюдения зависит от частоты сбоев: если ошибка повторялась раз в неделю, следите за сервисом не меньше месяца. Если сбой повторился, верните в работу ту же проблему, а не заводите новую. Так сохранится история расследования, и команда сразу увидит, какие гипотезы уже проверяли.
Кто отвечает за управление проблемами
В работе над проблемой обычно участвуют 4 роли. В небольшой команде один человек может совмещать несколько из них.
- Служба поддержки первой видит повторяющиеся обращения. Она собирает данные о том, кого затронул сбой, и предлагает пользователям обходные решения.
- Технические специалисты ищут причину, проверяют гипотезы и внедряют исправление.
- Владелец сервиса оценивает, насколько сбой влияет на бизнес, помогает определить приоритет и решает, можно ли оставить известную ошибку с принятым риском.
- Менеджер проблем (Problem Manager) следит, чтобы проблему зарегистрировали, организует расследование и контролирует выполнение задач. В небольшой команде эту роль часто берет на себя руководитель поддержки или технический лидер.
Важно, чтобы у каждой проблемы был ответственный, который доводит ее до решения и собирает участников, если работа остановилась.
Метрики управления проблемами
Время восстановления сервиса показывает, как быстро команда справляется с инцидентами, но не объясняет, устраняет ли она их причины. Для этого нужны отдельные метрики.
| Метрика | Что показывает |
|---|---|
| Число повторных инцидентов и их влияние на бизнес | Стало ли меньше повторных сбоев и потерянного рабочего времени |
| Число новых, открытых и критичных проблем | Как меняется объем работы и где остаются серьезные риски |
| Среднее время до установления причины и до проверенного исправления | На каком этапе задерживается работа: в расследовании или во внедрении |
| Число известных ошибок и доля проблем с описанным обходным решением | Насколько поддержка готова к повторным сбоям |
| Число проблем, найденных до инцидентов | Получается ли у команды находить причины заранее |
| Доля проблем, по которым инциденты вернулись после исправления | Насколько устойчив результат работы |
Для последней метрики сначала задайте период наблюдения после исправления, например 30 дней. Затем посчитайте:
Доля повторений = проблемы, по которым вернулись инциденты / все проблемы, исправленные и проверенные за тот же период × 100%
Как организовать управление проблемами в Kaiten
Kaiten — российская платформа для управления задачами, проектами и командной работой, где весь процесс управления проблемами можно выстроить в одном пространстве. Поддержка, разработчики и инфраструктурная команда работают с одними карточками, а связи между задачами и автоматизации помогают ничего не потерять.
Создайте доску «Проблемы». Добавьте колонки по этапам процесса: «Новые», «Расследование», «Исправление», «Проверка», «Закрыто». Так видно, на каком этапе каждая проблема и где собирается очередь.
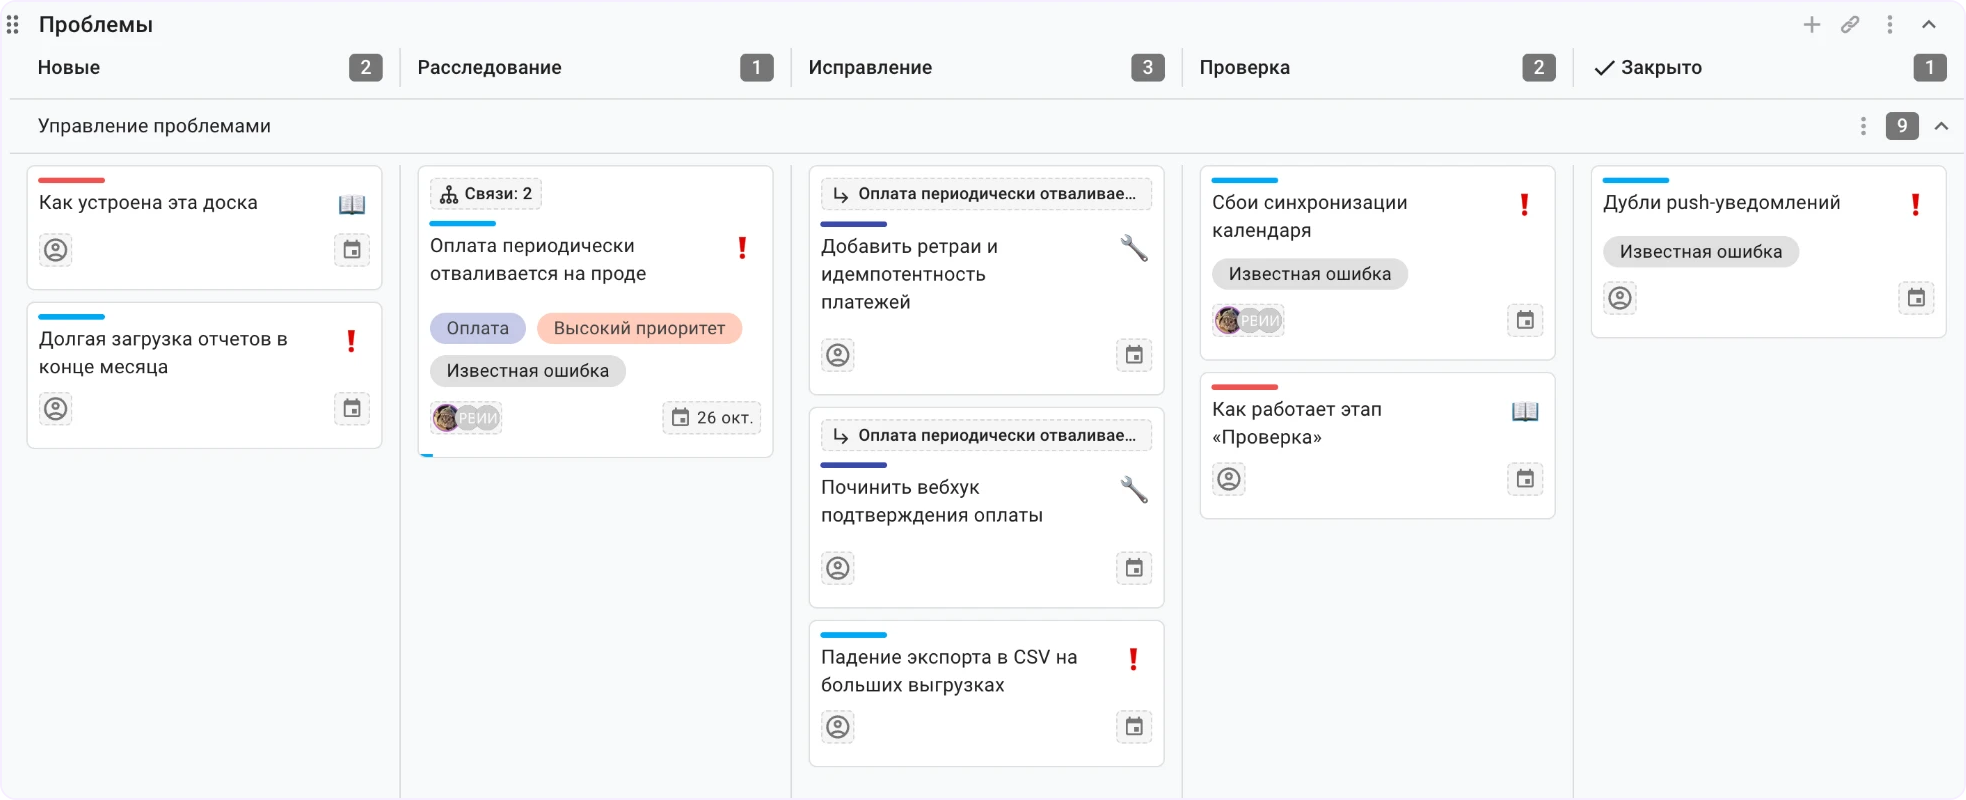
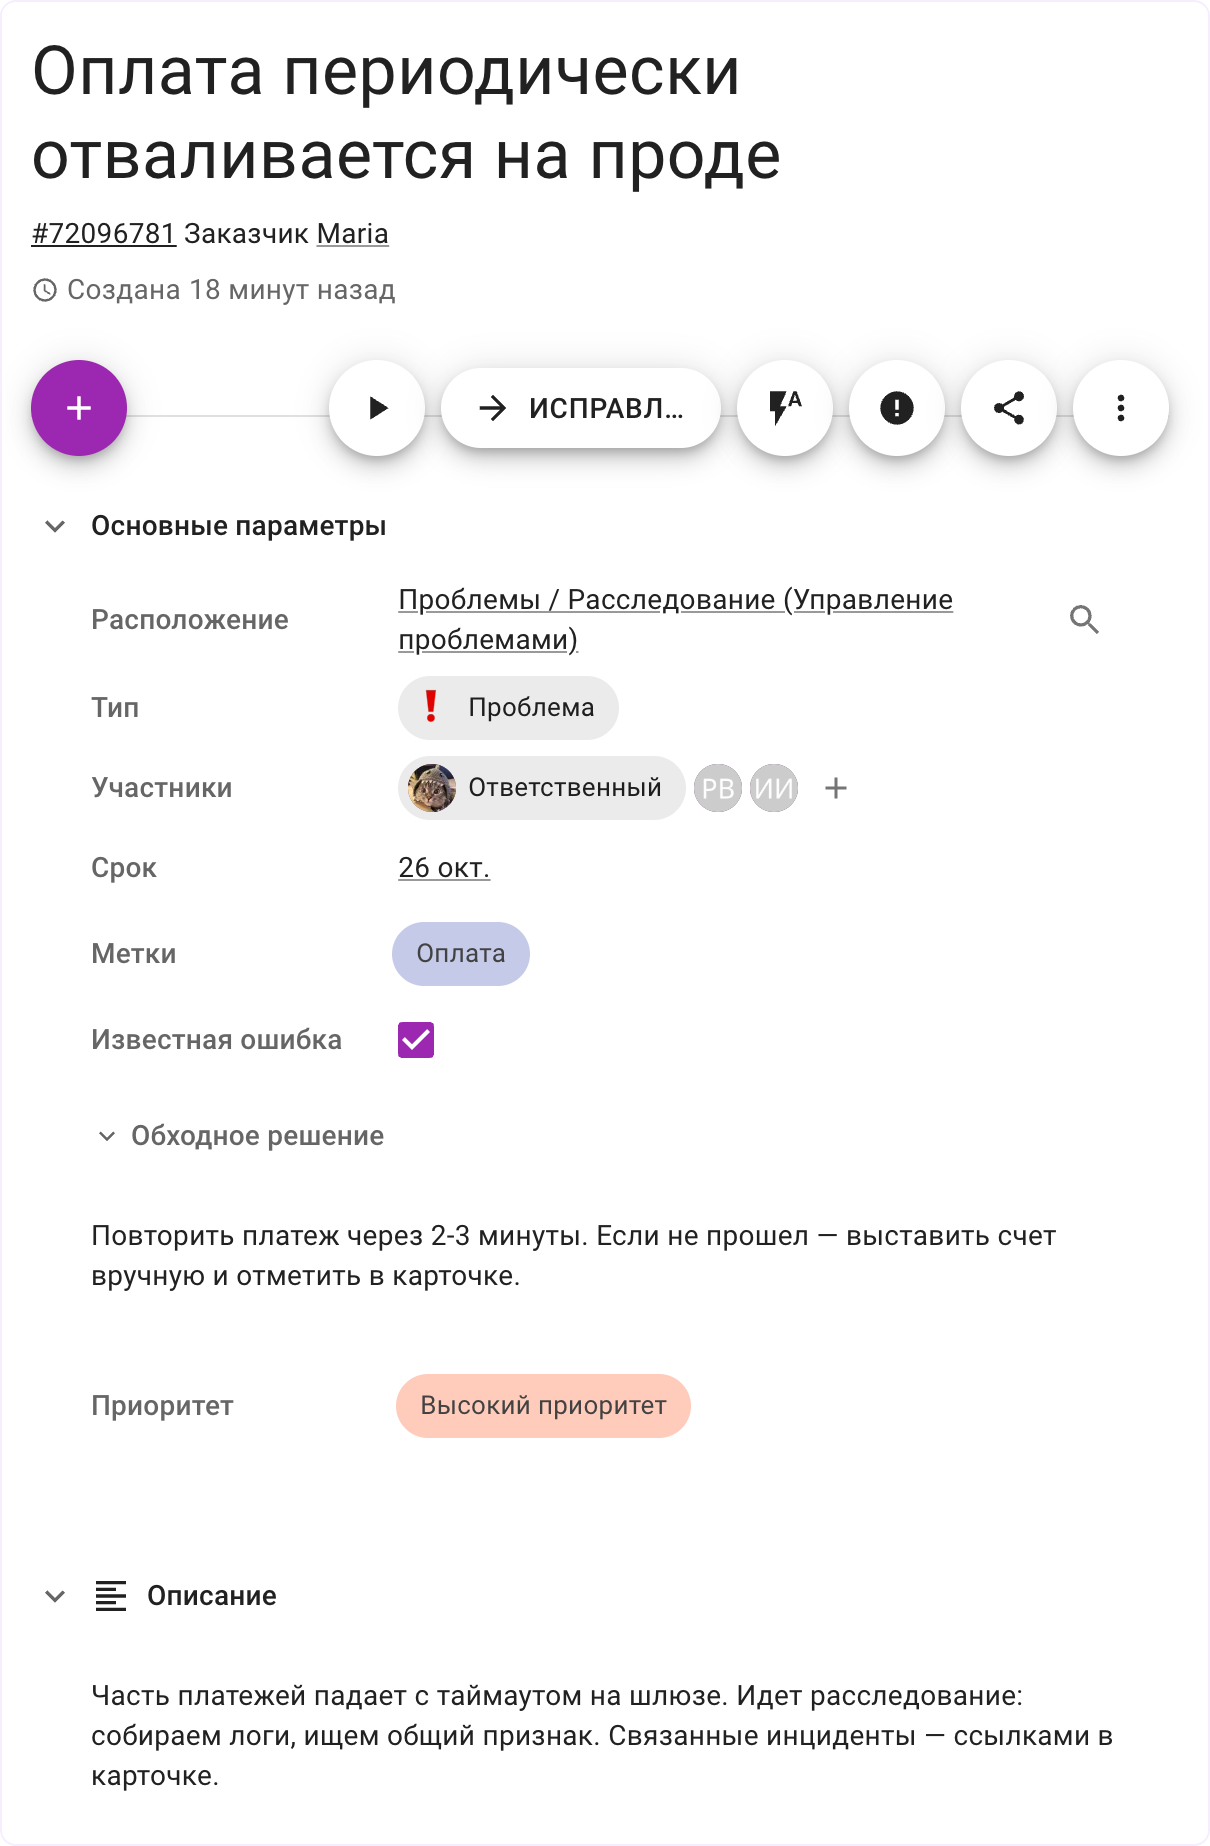
Заполните карточку проблемы. Укажите ответственного, приоритет и срок, добавьте ссылки на связанные инциденты. Признак известной ошибки и обходное решение вынесите в отдельные поля карточки. Эти сведения нужны на всех этапах, и в полях их проще найти, чем в описании.
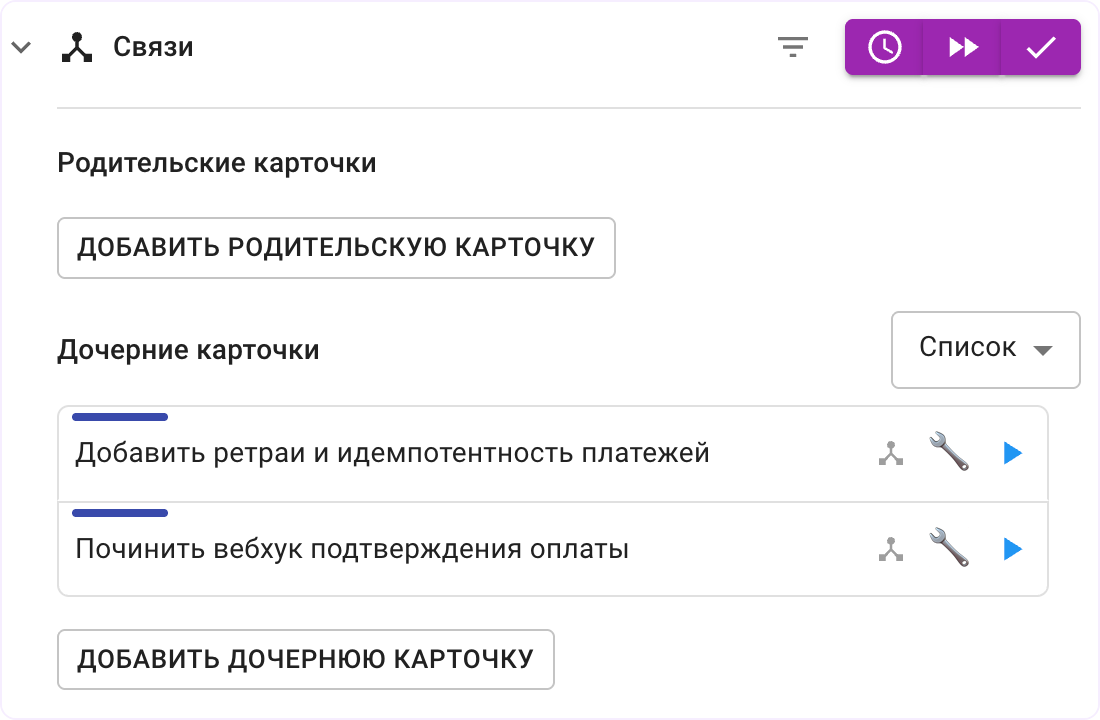
Задачи на исправление создавайте дочерними карточками с исполнителями. В основной карточке будет виден прогресс по каждой из них.
Настройте автоматизации — они возьмут на себя рутинные действия. Например, автоматическое назначение свободного сотрудника ответственным, когда обращение о сбое переходит на этап «Расследование».
Сохраните результаты разбора. Причину сбоя, выводы разбора и инструкции для поддержки сохраните в Базе знаний. Так команда найдет их, если похожий сбой повторится.
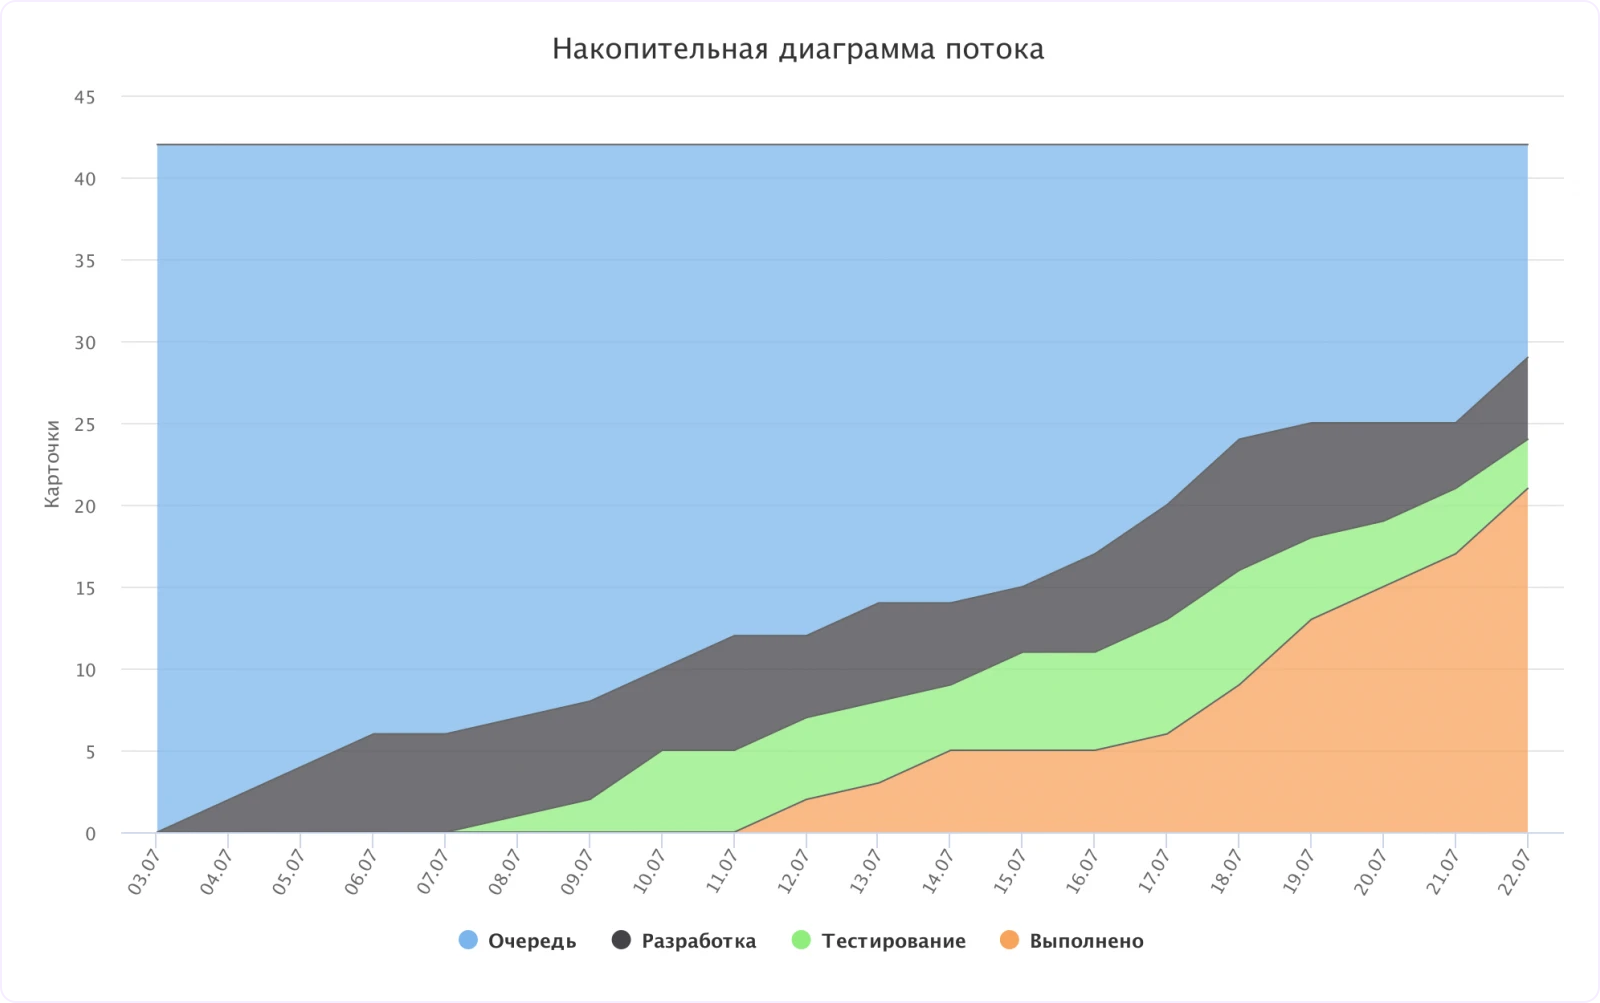
Проверьте результат. Карточка остается в колонке «Проверка», пока команда не убедится по мониторингу, тестам и новым обращениям, что сбой не повторяется. Чтобы найти, где процесс тормозит, используйте отчеты. Например, накопительная диаграмма потока (CFD) покажет, на каком этапе проблемы скапливаются чаще всего.
Если не хочется настраивать доску с нуля, начните с готового шаблона для работы с инцидентами: в нем уже есть этапы, постмортемы и корректирующие меры.
Типичные ошибки проблем-менеджмента
Даже когда процесс описан, команды часто допускают одни и те же ошибки:
- Создание проблемы после каждого обращения. Проблем становится больше, чем команда успевает разобрать.
- Закрытие проблемы без поиска причины сбоя. Сервис снова работает, но причина сбоя осталась.
- Поиск виноватого. Команда обсуждает, кто ошибся, и не замечает пробелы в правилах работы.
- Хранение инструкции в личной переписке. Специалистам приходится заново разбираться в уже известной ошибке.
- Разбор только частых сбоев. Редкий, но критичный отказ может нанести больше ущерба.
- Отсутствие задач по итогам разбора. Причина найдена, но исправлять ее никто не начал.
- Отказ от пересмотра открытых проблем. Нагрузка меняется, и обходное решение со временем может перестать работать.
Большинство этих ошибок возникает, когда работа с проблемой происходит без контроля: без ответственного, записи результатов и проверки исправления.
Вывод: с чего начать управление проблемами
Управление проблемами можно внедрять постепенно. Рекомендации ITIL не обязывают нанимать отдельного специалиста, внедрять специальную систему для базы известных ошибок или разбирать каждый инцидент. Не обязательно и исправлять все найденные проблемы: некоторые риски компания может осознанно принять.
Главное — чтобы ни одна проблема не терялась, а работа над ней заканчивалась конкретным результатом.
Поэтому начать можно с малого: выберите один повторяющийся сбой, на который чаще всего жалуются пользователи, и пройдите с ним все этапы — от поиска причины до проверки исправления. Так команда поймет, какие шаги ей нужны, и сможет применить этот опыт к остальным проблемам.
Если у вас остались вопросы по настройке Kaiten для управления проблемами, загляните в базу знаний: там подробно описаны все возможности платформы.
